Le contexte général
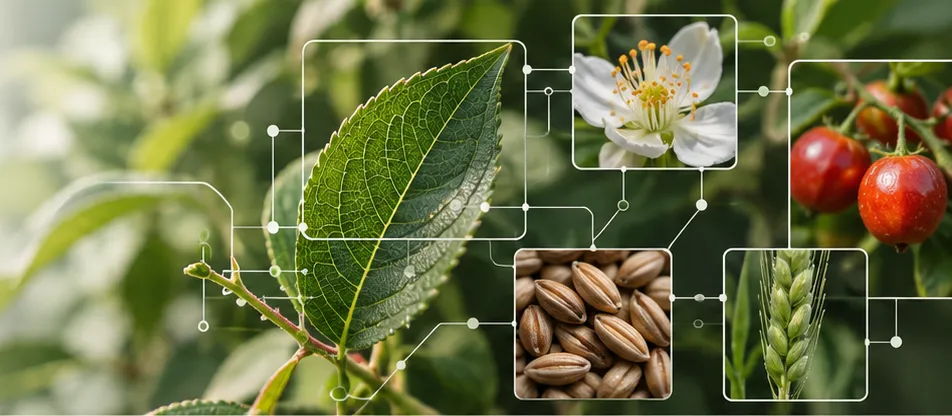
L’identification et la caractérisation des plantes entières, feuilles, fleurs, fruits et graines à l’échelle des variétés constituent un enjeu important pour de nombreux domaines : sélection variétale, agriculture, gestion des ressources génétiques, conservation, traçabilité ou encore phénotypage. Ces dernières années, le développement de nouvelles ressources numériques et les progrès rapides de l’IA ouvrent de nouvelles perspectives pour l’automatisation de l’identification des plantes à un niveau infraspécifique.
Cela reste cependant difficile, car les différences visuelles sont souvent très subtiles, localisées sur certains organes et influencées par les conditions environnementales. Il s’agit ainsi d’un problème d’identification visuelle à très fine échelle, encore largement ouvert en conditions réelles. Ces développements en IA demandent également le développement, le maintien et la mise à disposition de grandes bases de données d’images labellisées à l’échelle variétale et de référentiels taxonomiques à l’échelle de ces variétés.
L’objectif de cette journée
L’objectif est avant tout de dresser un panorama des initiatives existantes et de favoriser les échanges entre communautés qui travaillent parfois sur des problématiques proches sans nécessairement avoir l’occasion d’interagir.
La journée permettra notamment de discuter :
- des bases de données et collections existantes sur les variétés ;
- de la constitution, de l’annotation, de la standardisation et du partage de jeux de données ;
- des méthodes de vision par ordinateur permettant d’identifier ou de caractériser des variétés ;
- des difficultés propres au niveau variétal, comme la forte similarité visuelle entre variétés, la variabilité intra-variétale, l’influence des conditions de culture ou le manque de données annotées ;
- des besoins scientifiques et applicatifs et des opportunités de collaborations.
Un évènement ouvert à différentes communautés
Cette journée souhaite réunir des acteurs issus de domaines complémentaires : data science, intelligence artificielle, vision par ordinateur, agronomie, botanique, génétique et amélioration des plantes, phénotypage, semences, ressources génétiques et biodiversité cultivée. Chercheurs, ingénieurs, gestionnaires de collections et de bases de données, instituts techniques, infrastructures de recherche et autres acteurs travaillant sur ces questions sont invités.
Aucune participation préalable au projet Pl@ntAgroEco ou à Pl@ntNet n’est nécessaire.